前言
最近挖到了一个很有意思的开源项目:MiniMind-O,是 Jingyao Gong 做的一个全模态模型。
一开始看到 0.1B 参数的时候我是很意外的,但仔细一看发现它居然同时支持 文本、语音、图像 三种模态输入,输出 文本 + 流式语音,而且号称可以在消费级显卡上跑。本着试试的心态就折腾了一下 (´・ω・`)
结果还真有点东西
我的设备情况
我只有一台笔记本,但这台笔记本通过 OCulink 外接了一张 RTX 5060:
| 模式 | CPU | GPU | 内存 | 说明 |
|---|---|---|---|---|
| 🖥️ 外接显卡 | AMD Ryzen AI 9 H 365 (10核20线程) | RTX 5060 8GB (Blackwell) | 32GB | OCulink 连接,CUDA 加速推理 |
| 💻 纯核显 | AMD Ryzen AI 9 H 365 (10核20线程) | AMD Radeon 880M (512MB) | 32GB | 拔掉外接显卡,只用笔记本自身核显 |
笔记本型号是机械革命无界系列。所以所谓的“核显也能跑”,是真的把外接显卡拔掉的效果。能在 880M 核显上跑通一个全模态模型的实时视频通话,确实挺意外的
0.1B 究竟意味着什么
现在市面上主流的大模型动辄 7B、13B、70B、甚至 671B… 0.1B(也就是 1 亿参数)放在里面基本上就是蝼蚁级别。
它能这么小,是因为很多活交给了外挂的编码器,主模型本身只有一亿出头:
主模型(Thinker + Talker):113M 参数
├── Thinker(语言核心):63.91M
├── Talker(语音生成):47.05M
├── 音频投影层:0.99M
└── 视觉投影层:1.18M

外挂编码器(冻结,不参与训练):
├── SenseVoice 语音编码器:234M
├── SigLIP2 视觉编码器:95M
└── Mimi 音频编解码器:96M
不过这些编码器推理时也要加载进显存/内存,实际跑起来总共大概 538M 参数…但还是很小
环境搭建过程
PyTorch 版本踩坑
第一个坑来得很快。RTX 5060 是 Blackwell 架构(sm_120),PyTorch 2.6 自带的 CUDA 内核只编到 sm_90,装完直接跑不起来,报一堆看不懂的 CUDA 错误
查了一下要 PyTorch 2.7+cu128 以上才认 50 系,我装的是 PyTorch 2.11.0+cu128,装完就好了
pip uninstall torch torchvision torchaudio -y
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu128
模型资源下载
要下的东西大概 1.6GB,大头是各种编码器,主权重本身才 227MB
model/
├── SenseVoiceSmall/    (447MB)  语音编码器
├── siglip2-base-p32-256-ve/ (180MB) 视觉编码器
├── mimi/               (183MB)  音频编解码器
├── campplus/           (13.5MB) 说话人编码器
├── speaker/            (内置音色)
└── vad/                (语音活动检测)

out/
├── sft_omni_768.pth    (227MB)  ← 主要权重
├── sft_omni_768_moe.pth (610MB) ← MoE 版本
├── llm_768.pth         (基座模型)
└── sft_zero_768.pth    (零阶段权重)
推理体验
命令行模式
最简单的测试方式就是跑一段命令行推理:
python eval_omni.py --load_from model --weight sft_omni --mode 0默认会用英文问 7 个问题,模型输出文字回答,同时生成语音帧
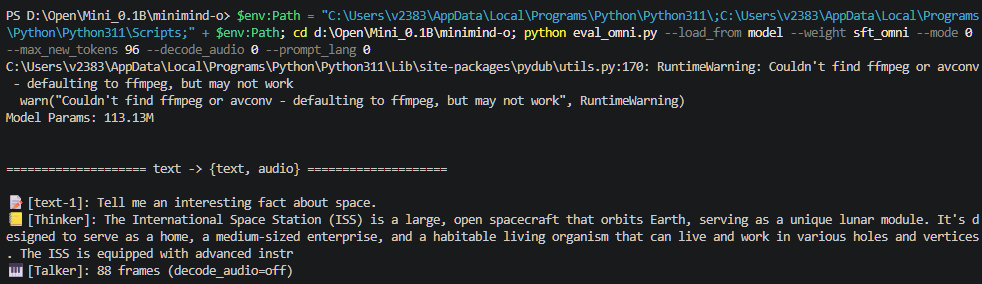
回答质量嘛…很 0.1B。句子重复、逻辑乱跳,有时候前言不搭后语。不过这个体量能说出完整的英文句子,已经可以了
Gradio Web UI
然后试了 Gradio 版的 Web 界面:
python web_demo_omni.py --load_from ../ --port 8888打开 http://localhost:8888 就能看到一个聊天界面。
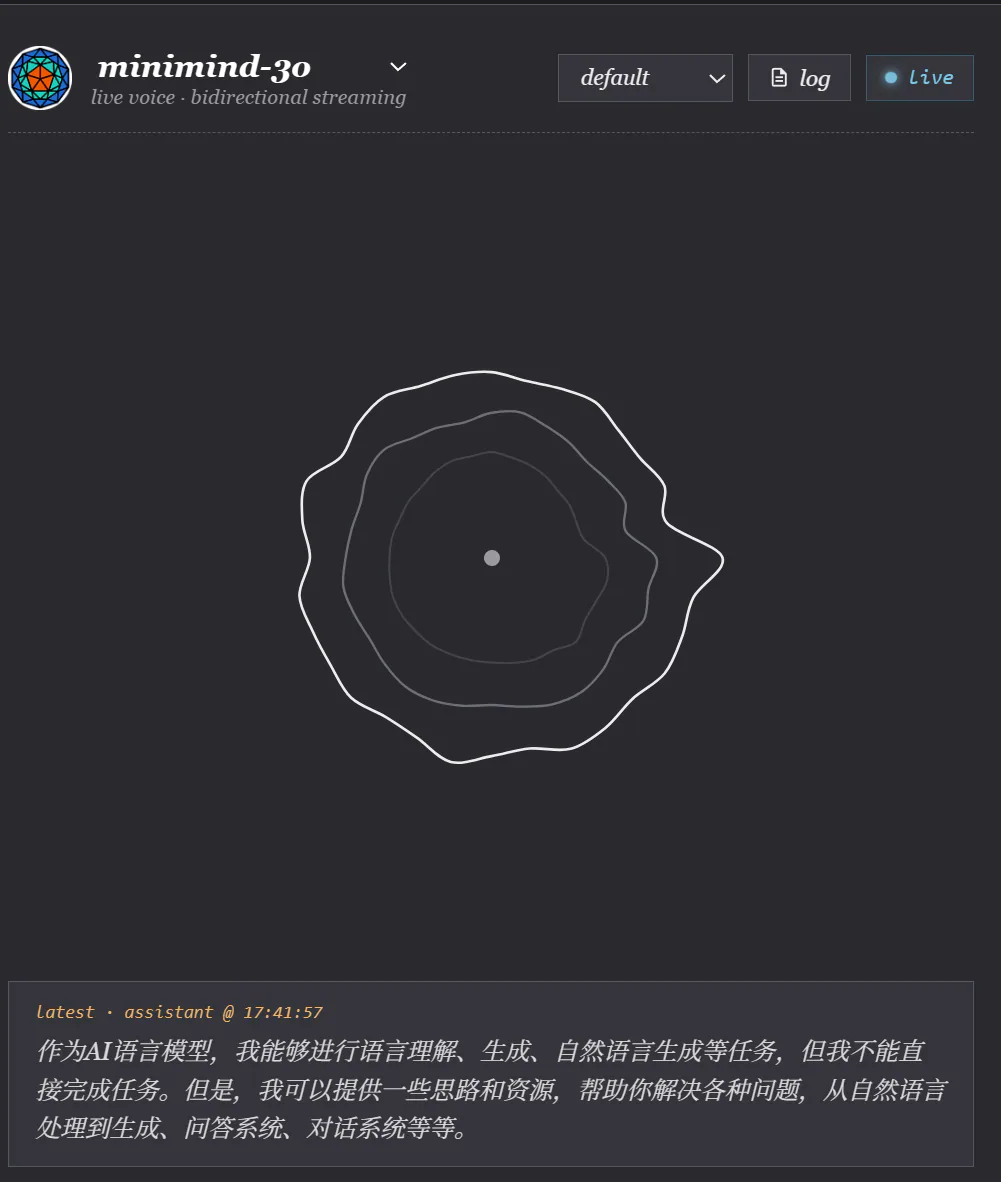
可以打字、传语音、传图片,模型回文字加合成语音,还有 12 种音色可以换
视频通话
这个是我觉得最好玩的部分 (`・ω・´)
项目还带了一个 Flask 版的 Web UI,支持实时视频通话:
cd webui
python web_demo.py --load_from ../ --port 7860
打开 http://localhost:7860/call,打开摄像头,按住说话键,模型就会实时捕捉视频画面 + 语音输入,然后通过语音回答你
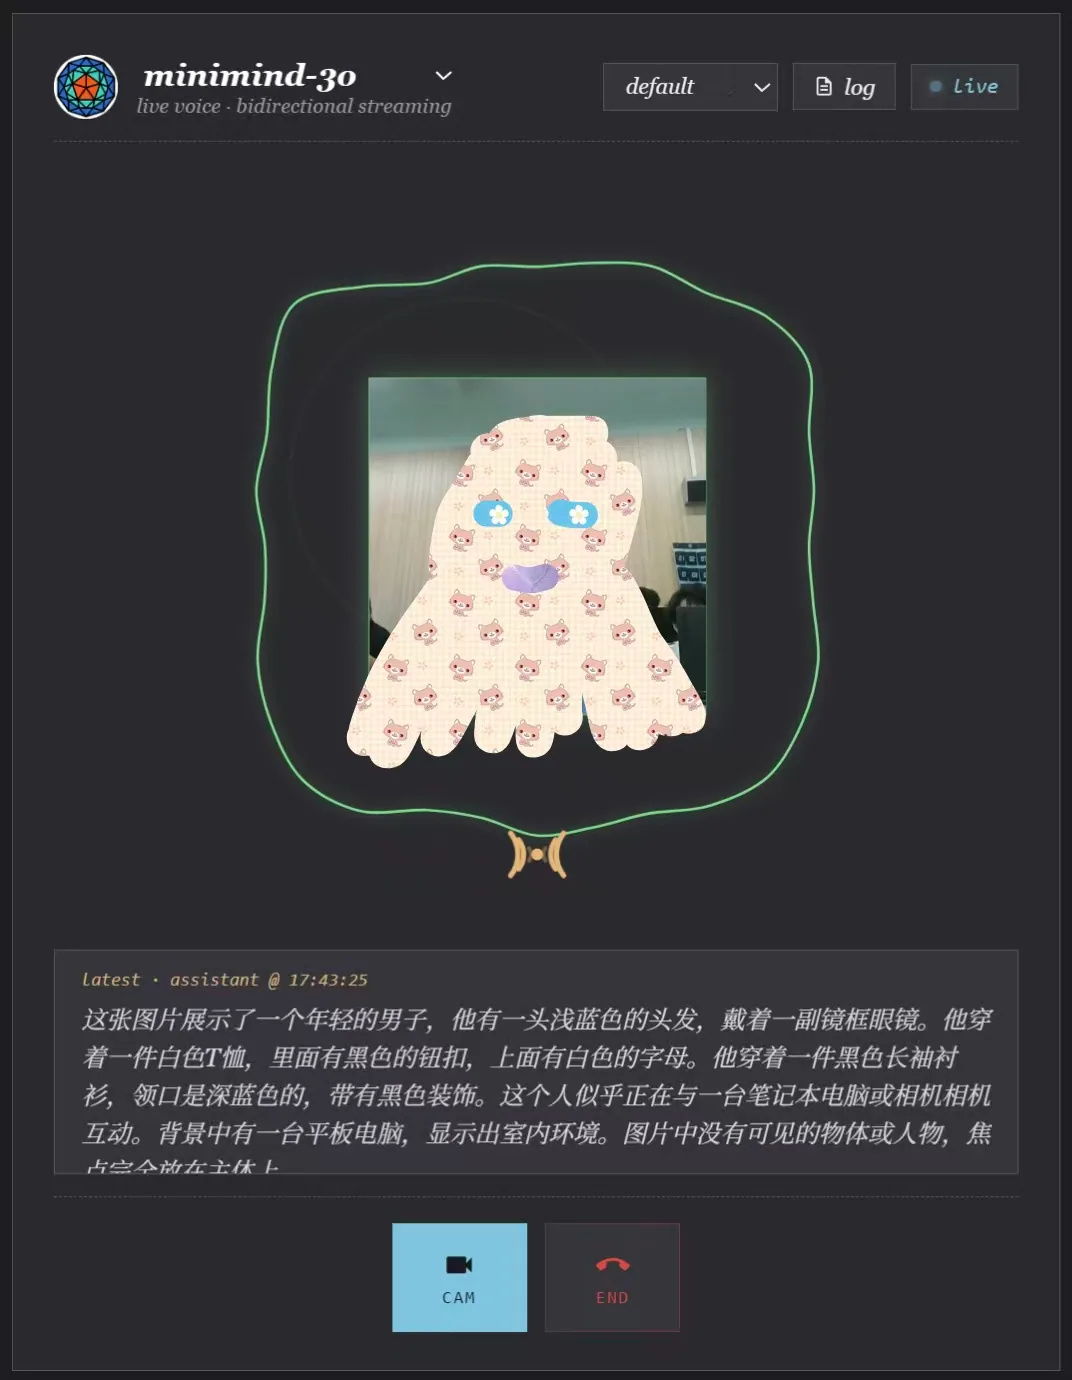
在 AMD 880M 核显 上居然也跑起来了,画面和语音都能正常交互,有一点延迟,但能用。一个 0.1B 的模型在核显上视频通话,还挺魔幻的
图片分析能力测试
既然是全模态,那肯定要喂几张图试试
测试一:初音未来 × JavaScript 海报
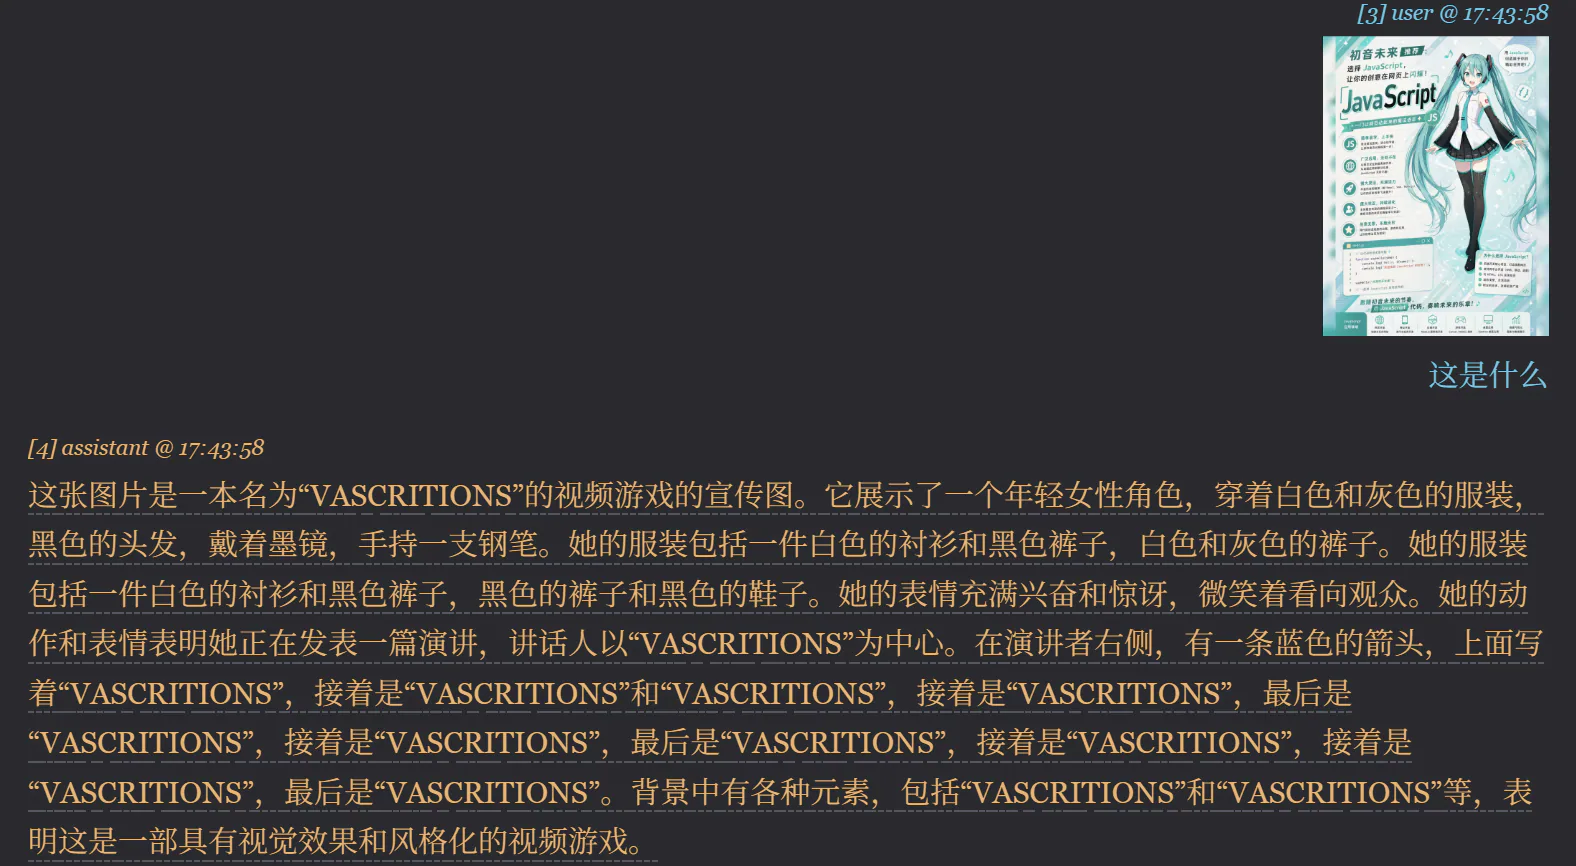
喂了一张初音未来当主角的 JavaScript 宣传海报
结果嘛…它完全没认出这是初音未来
后半段开始疯狂重复“VASCRITIONS”,句子也崩了
大概能看出它知道画面里有个人物,但人物、衣服、姿势基本都说错了,名字乱编,海报上的字一个都没认出来。0.1B 的眼睛也就这样了 (´・ω・`)
测试二:Linux 作业截图
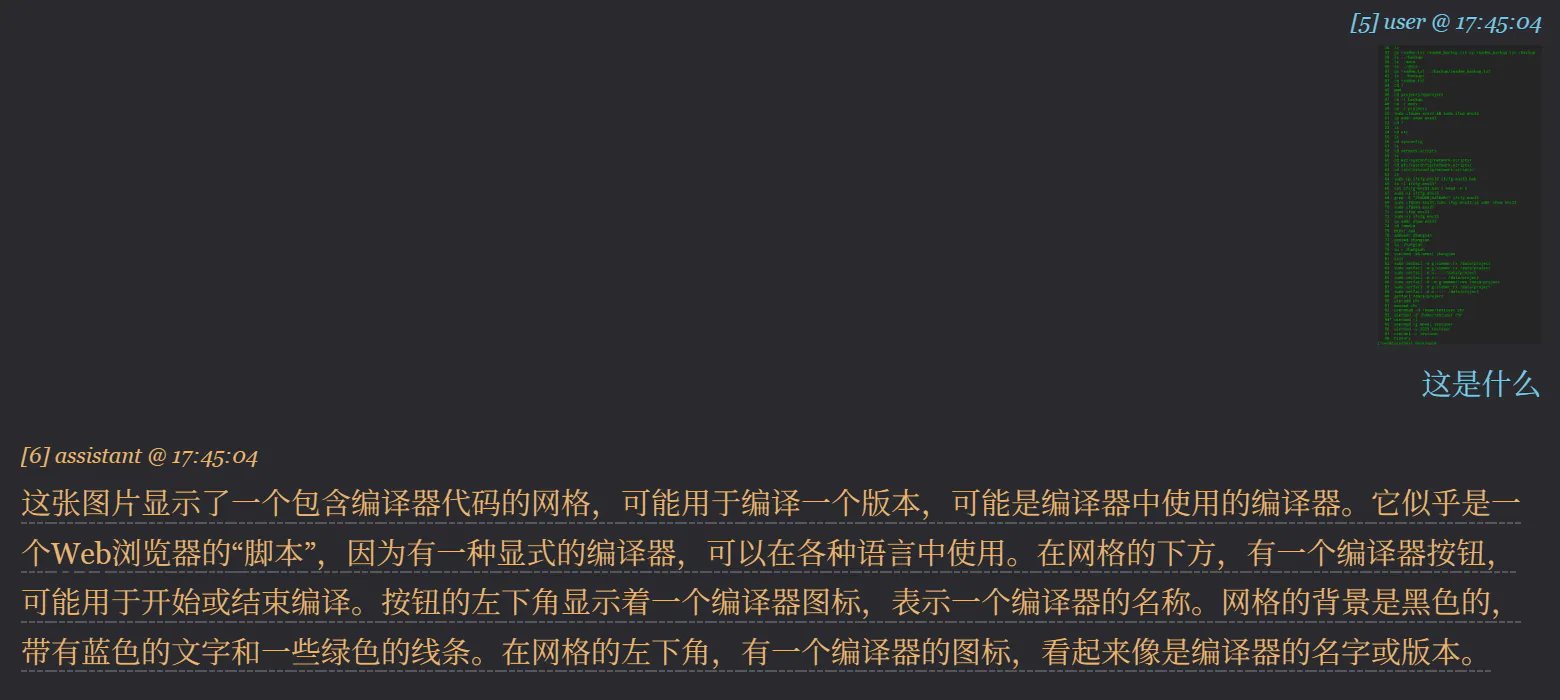
这张好一些,能认出是终端、有人在敲命令。具体是什么命令、输出了什么就全说错了,但至少方向对了
在轻薄本(核显)上跑的体验
一开始没抱什么期望,核显跑深度学习模型,在我印象里跟骑自行车上高速差不多 (´・_・`)
但实际跑下来:
- 文本对话:毫无压力,秒回
- 语音输入:1s 以内,基本感觉不到延迟
- 图片问答:也是 1s 以内出结果
- 视频通话:核显也能跑,画面实时捕获 + 语音流处理
比我想的好太多了,本来以为语音和图片要等好几秒
当然快是因为模型小,回答的“智商”也就那样。问它人生的意义,它会给你一段看着挺像回事、细想全是空话的回答
一些主观感受
好的地方:核显都能跑,基本没有硬件门槛;跟着 README 半小时到一小时就能跑起来;代码是纯 PyTorch 写的,挺好读;从训练、推理到 Web UI 都有,还带视频通话
不好的地方也很明显:0.1B 就是 0.1B,别指望它写代码或者推理;训练数据偏英文,中文更弱;合成语音能听,但离自然还差得远;核显上视频通话能感觉到一点延迟;海报、二次元这类图基本看不懂
不过体量摆在那,能做到这样我已经挺惊喜了 (`・ω・´)
总结
单项拿出来哪个都不强,但一个 0.1B 的模型能看、能听、能说,还能在轻薄本核显上跑,在自己电脑上跑起来还是挺酷的。想了解全模态模型大概怎么搭的话,这个项目很适合拿来看代码
之后打算用 RTX 5060 的 8GB 显存试试训练主模型,能跑通的话再写一篇 ( ´ ▽ ` )ノ
项目地址:https://github.com/jingyaogong/minimind-o
设备环境:AMD Ryzen AI 9 H 365 / 32GB 内存,通过 OCulink 外接 RTX 5060(8GB 显存),拔掉外接后回退至 AMD Radeon 880M 核显
留言
评论区暂未开放;可先通过 RSS 或「关于」页联系。